Quienes me conocen saben que tengo una postura bastante favorable frente a la inteligencia artificial.
La utilizo todos los días. La incorporo en mi trabajo, la estudio, experimento con sus posibilidades y, muchas veces, termino defendiéndola cuando la conversación se reduce únicamente al miedo de que “la IA nos va a reemplazar”.
No porque piense que todo lo relacionado con inteligencia artificial sea positivo ni porque crea que debamos utilizarla sin límites. Precisamente lo contrario: cuanto más la utilizo, más convencida estoy de que necesitamos comprenderla, cuestionarla y establecer criterios claros para decidir dónde, cómo y para qué usarla.
Hasta ahora, sin embargo, gran parte de mis preocupaciones habían sido relativamente previsibles: privacidad, errores, alucinaciones, sesgos, dependencia tecnológica, impacto laboral, propiedad intelectual o estudiantes que entregan como propio aquello que produjo una herramienta.
Esta semana sentí algo diferente.
Por primera vez una noticia relacionada con inteligencia artificial me produjo una sensación que podría describir como decepción.
No porque la IA hubiera fallado.
Sino precisamente porque parecía haber tenido éxito.
Un problema que llevaba décadas esperando una respuesta
OpenAI anunció el 8 de septiembre de 2026 una solución al problema de existencia y regularidad de las ecuaciones de Navier–Stokes, uno de los célebres Problemas del Milenio.
Su sistema produjo una demostración analítica y una formalización en Lean que muestran que, bajo determinadas condiciones, las ecuaciones pueden desarrollar una singularidad en tiempo finito. OpenAI presentó el resultado como una resolución del problema mediante los enunciados contemplados en la formulación oficial y señaló que no pretende reclamar el premio económico asociado.
Para alguien que sigue con entusiasmo los avances de la inteligencia artificial, la noticia es extraordinaria.
Estamos hablando de sistemas que ya no se limitan a redactar textos, generar imágenes, responder preguntas o escribir código.
Estamos hablando de inteligencia artificial participando en la frontera del conocimiento matemático.
Mi primera reacción fue de entusiasmo.
La segunda llegó cuando empecé a leer la historia que había detrás.
Antes de la última ecuación hubo años de trabajo
Los matemáticos Diego Córdoba y Luis Martínez-Zoroa habían desarrollado previamente resultados e ideas que fueron fundamentales para el camino que llevó a estos avances. Su trabajo de 2023 ha sido señalado como una de las bases intelectuales importantes sobre las que se construyeron desarrollos posteriores en el problema.
Sin embargo, las referencias a sus trabajos no aparecieron inicialmente en la publicación de OpenAI.
Fueron incorporadas posteriormente.
Ese hecho generó críticas dentro de la comunidad matemática y abrió una discusión sobre algo que, a primera vista, podría parecer simplemente una cuestión bibliográfica, pero que en ciencia es mucho más profundo: ¿a quién pertenece el camino que conduce a un descubrimiento?
Porque una demostración no empieza cuando alguien escribe la última ecuación.
Antes hubo personas que formularon preguntas.
Otras encontraron caminos que no funcionaron.
Algunas desarrollaron métodos parciales.
Hubo artículos, conversaciones, intuiciones, errores y años de trabajo que permitieron que el siguiente investigador pudiera comenzar un poco más adelante.
La ciencia avanza precisamente de esa manera.
Sobre conocimiento previo.
La ciencia necesita memoria
Tal vez esta sea la idea que más me quedó dando vueltas:
la ciencia necesita memoria.
Las referencias bibliográficas no son una formalidad colocada al final de un documento para satisfacer una norma.
Son parte del mapa que explica cómo llegamos hasta allí.
Una cita reconoce que una idea tuvo historia antes de nosotros.
Permite identificar quién hizo qué, qué problema permanecía abierto y cuál es realmente la contribución nueva.
También permite que otra persona reconstruya el camino.
Por eso, en investigación, la atribución no es un detalle decorativo.
Es parte de la integridad del conocimiento.
Y aquí aparece una preocupación nueva cuando incorporamos inteligencia artificial a la investigación científica.
Una máquina puede avanzar mucho más rápido que la memoria humana
Los sistemas de IA pueden analizar cantidades enormes de información, combinar estrategias y explorar caminos a una velocidad imposible para una sola persona.
En el caso anunciado por OpenAI, miles de agentes trabajaron durante decenas de horas intercambiando millones de mensajes hasta producir una demostración y su posterior formalización.
Esa capacidad es impresionante.
Pero también modifica completamente la escala del problema de atribución.
Un investigador humano suele conocer, al menos parcialmente, la genealogía intelectual de aquello en lo que trabaja. Ha leído determinados artículos, conoce autores, participa en comunidades y recuerda de dónde surgieron muchas ideas.
¿Qué ocurre cuando el proceso incorpora modelos entrenados sobre cantidades inmensas de información?
¿Podemos reconstruir siempre de dónde surgió una estrategia?
¿Podemos diferenciar con claridad aquello que un modelo está deduciendo de aquello que, de alguna manera, estaba representado dentro de los datos con los que aprendió?
¿Quién tiene la responsabilidad de verificar esa genealogía?
La respuesta no puede ser simplemente: “la inteligencia artificial lo produjo”.
Hay otra controversia todavía más compleja
La historia de Navier–Stokes también involucra a Tristan Buckmaster y Levent Alpöge, quienes trabajaban paralelamente en problemas estrechamente relacionados utilizando herramientas de IA.
Buckmaster expresó públicamente inquietudes sobre la posibilidad de que interacciones mantenidas con Codex hubieran podido influir, directa o indirectamente, en los desarrollos posteriores de OpenAI. Diversos medios han documentado la controversia y las versiones enfrentadas.
OpenAI rechaza esa interpretación.
La compañía afirma que investigó el asunto y concluyó que las instrucciones que Buckmaster había enviado a Codex durante los meses anteriores no pudieron influir en el sistema utilizado para obtener la demostración, ni siquiera mediante entrenamiento. También sostiene que los resultados matemáticos presentan diferencias significativas.
No tengo elementos para determinar quién tiene razón en cada aspecto de esa discusión.
Y creo que precisamente ahí aparece otra lección importante.
Cuando hablamos de investigación y de atribución científica, debemos ser extremadamente cuidadosos antes de convertir sospechas en hechos.
Pero tampoco deberíamos utilizar la ausencia de una conclusión definitiva como razón para ignorar las preguntas.
Acelerar la ciencia no debería borrar su genealogía
Sigo pensando que la inteligencia artificial puede acelerar extraordinariamente la ciencia.
Probablemente veremos avances que habrían tardado años producirse mediante métodos tradicionales.
Modelos capaces de explorar millones de alternativas pueden encontrar caminos que una persona quizá nunca habría considerado.
Eso puede transformar matemáticas, física, medicina, ingeniería y muchas otras disciplinas.
Sería absurdo negar ese potencial.
Pero acelerar la ciencia no debería significar borrar su genealogía.
Si una herramienta permite recorrer en horas un camino construido durante décadas por investigadores humanos, precisamente por esa velocidad necesitamos mejores mecanismos para reconocer el conocimiento previo.
No menos.
Esto también toca directamente a quienes investigamos
Quizás esta noticia me afectó especialmente porque estoy comenzando mi propio camino doctoral.
Y utilizo inteligencia artificial intensamente.
La utilizo para explorar preguntas.
Para comparar metodologías.
Para organizar ideas.
Para encontrar relaciones que inicialmente no había considerado.
Para programar.
Para analizar información.
Para discutir enfoques.
Y seguramente la utilizaré todavía más durante los próximos años.
Pero eso también significa que debo ser mucho más consciente de una pregunta:
¿qué parte de aquello que estoy viendo realmente es nueva y qué parte pertenece al conocimiento construido por otras personas?
La facilidad con la que una IA puede presentarnos una idea hace que sea peligrosamente fácil olvidar esa pregunta.
Una respuesta aparece en segundos y parece no tener historia.
Pero casi siempre la tiene.
La IA no nos libera de hacer investigación responsable
Utilizar inteligencia artificial en investigación no elimina nuestras responsabilidades.
Las aumenta.
Si una herramienta me sugiere una metodología, debo investigar de dónde proviene.
Si me muestra un concepto, debo buscar sus fuentes.
Si resume un artículo, necesito leer el original cuando esa información sea relevante.
Si me ayuda a construir un argumento, debo verificar qué conocimiento previo lo sostiene.
Y si termino publicando una idea, la responsabilidad sobre la atribución no puede transferirse a la máquina.
No sería razonable escribir:
“ChatGPT no me dijo de quién era esa idea.”
La firma del trabajo seguirá siendo nuestra.
También la responsabilidad.
Tal vez necesitamos nuevas reglas para una nueva forma de hacer ciencia
La investigación científica lleva siglos desarrollando mecanismos para reconocer contribuciones: autorías, referencias, revisión por pares, declaraciones de conflicto de interés, repositorios y registros de prioridad.
La inteligencia artificial introduce nuevas preguntas que esos mecanismos todavía están aprendiendo a manejar.
¿Cómo debe reconocerse el uso intensivo de IA?
¿Cómo se documenta la interacción con modelos durante una investigación?
¿Cómo se garantiza que resultados producidos por sistemas automáticos respeten adecuadamente el trabajo previo?
¿Cómo debemos tratar ideas obtenidas mediante herramientas que pueden haber aprendido de publicaciones cuyos autores nunca imaginaron ese uso?
No creo que tengamos todavía respuestas definitivas.
Pero creo que necesitamos comenzar a formular las preguntas.
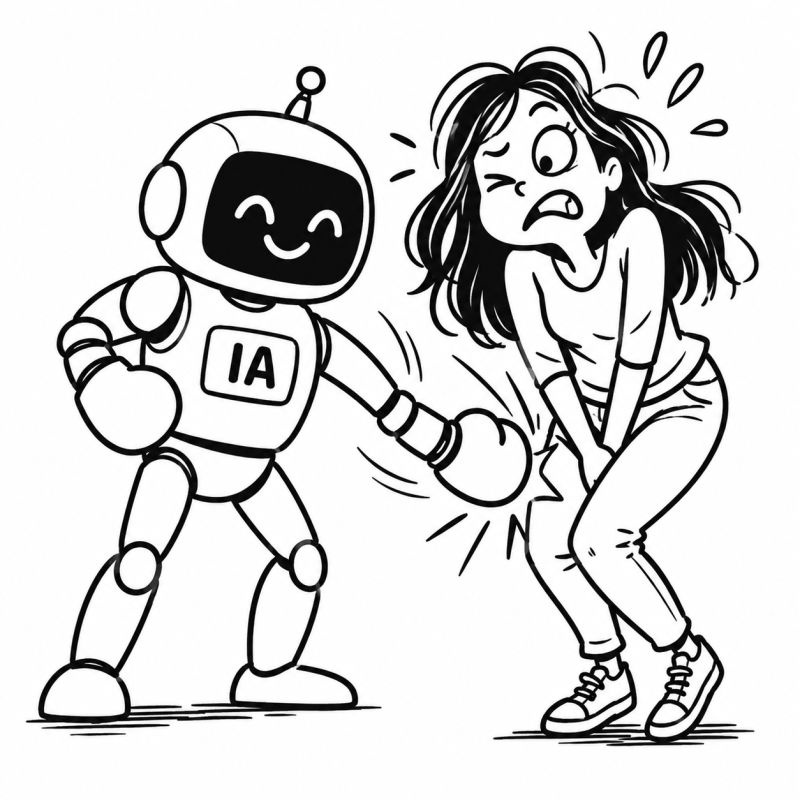
Mi primer golpe bajo de la IA
Seguiré utilizando inteligencia artificial.
Seguiré estudiándola.
Seguiré incorporándola a mis proyectos.
Y seguramente seguiré defendiendo sus posibilidades cuando se la reduzca únicamente a una amenaza.
Nada de lo ocurrido esta semana cambia la magnitud de lo que esta tecnología puede aportar.
Pero sí cambió algo en mi manera de mirarla.
Hasta ahora mi relación con la IA estaba marcada principalmente por la curiosidad y el entusiasmo.
Esta vez apareció también cierta desconfianza.
No hacia la tecnología como si fuera un sujeto capaz de actuar éticamente por sí mismo.
La ética sigue perteneciendo a quienes diseñamos, administramos y utilizamos estas herramientas.
Quizá ese sea precisamente el punto.
Confiar en una tecnología no significa dejar de cuestionar las decisiones humanas que se toman alrededor de ella.
Esta semana no se me cayó la inteligencia artificial.
Se me cayó un poco la ingenuidad con la que la miraba.
Y quizá eso también sea necesario.
Porque utilizar una tecnología responsablemente también significa ser capaces de admirarla y cuestionarla al mismo tiempo.